3D 关系图的极致优化:GPT-6.1 sol Ultra 的神力
AI 辅助声明:本文记录我这次使用 GPT-6.1 sol Ultra 协作优化项目的过程。代码实现、实验核对和文章初稿均有 AI 参与;性能数据来自本轮实际测试,源码、日志和未采用的方案均保留在文中链接的仓库记录里。
我本来只是想让博客宇宙在我的渣机上少喘两口气。
这个项目把独立博客之间的友链关系摆进一个 3D 宇宙,可以搜索博客、看邻居、找路径,也可以开着飞船到处逛。效果是挺有意思,但近五万个节点、十万多条关系摆在那里,构建和浏览器总得有人干活。
7 月我写过一篇《AI + Rust 两连发》,当时已经把 BFS 和力导布局做成了自己的 Rust 原生包。这次又让 GPT-6.1 sol Ultra 接着拧螺丝:前端要轻,构建要快,两个 Rust 包也别放过;先本地链接反复测,合理了再发版,最后换回正式包验证。
结果一路折腾下来,完整强制构建从 110.97 秒降到 54.01 秒,缓存命中平均约 7 秒;前端节点三角形从 176 万降到 9.8 万,同图全景渲染完成延迟降低了约一半。
只能说,这次的“神力”,确实有东西。不过比数字更有意思的,是它怎么把这些活一件件做完的。
先把“快”说清楚
我给它的要求里有一句:
尽可能降低渲染压力,极致性能优先,别空耗性能。
听起来像一句很宽泛的需求,真做起来却有好几种完全不同的“快”。
| 我在意的事 | 实际要检查什么 |
|---|---|
| build 别等太久 | 完整重算耗时、缓存命中耗时、峰值内存 |
| 拖动和飞行别卡 | 每次绘制的几何量、缓冲大小、CPU 与 GPU 工作 |
| 页面放着别白忙 | 静止时有没有继续申请 RAF、扫描标签和绘图 |
| 功能别被优化没了 | 全量图、精确统计、搜索、路径、邻居和飞行交互是否还在 |
所以这次没有拿一个 FPS 数字包打天下。构建、原生算法和浏览器渲染分开测,缓存命中也单独列。
测试机器是 Intel i7-1260P、约 14 GiB 内存,浏览器是 Linux 下的 Chrome 155,使用 Intel Iris Xe 集显。构建环境为 Bun 1.4.3、Rust 1.99.0;前端对照视口是 1920×906,DPR=1。
这里还得交代一个小细节:性能对照冻结在 8570 个正式站点、49,064 个图节点、107,527 条无向边。推送前合并了上游新增记录,最终产物变成 8571 个正式站点、49,064 个节点、107,528 条边。站点文件和图节点本来就是两个口径,后者还包含友链目标。新增关系后的布局不能直接混进旧图的精确对照里。
数据会变,测量时就先把它冻住。否则一边改代码、一边长图,最后快的是哪部分都说不清。
两个 Rust 包:已经是 native,也还能继续挤
这轮涉及三个仓库:
| 仓库 | 负责的工作 |
|---|---|
| FriendLinks | YAML 数据、构建管线、统计端点和 Three.js 前端 |
| bfs-rs | 全源 BFS,生成六度分隔距离分布 |
| force-rs | Barnes-Hut 力导布局,算出节点三维坐标 |
第一次把 JS 换成 Rust,收益已经很明显。但“换成 Rust”不会自动让算法和数据流走到头。这次比较有意思的,就是继续往 native 里面查,而不是看到 .node 文件就觉得没什么能做了。
BFS:把多次遍历中重复的活合起来
六度分隔统计要从不同源点出发,计算到其他节点的距离分布。这里用到的思路来自论文 The More the Merrier: Efficient Multi-Source Graph Traversal:多次独立 BFS 会访问相同的图,可以共享其中的邻接扫描工作。
新实现把 64 个来源的状态放进一个 u64,用位运算一起推进,同时根据前沿规模选择 push / pull。每一位仍对应独立来源,保留各来源的距离统计。
再往下,确认图严格无向后,对相同邻居集合的节点做精确加权合并。我的这份图在这一步缩成了 19,479 个加权节点,最终距离计数按权重还原。小图、长路径等形状保留独立 BFS 的回退路径。
真实图的独立进程基准是这样的:
| 实现 | 耗时 |
|---|---|
| 已发布旧包 0.2.3,单次基线 | 15,172 ms |
| 普通 64 来源位并行 push,中位数 | 1,765 ms |
| 加权合并后的 push,中位数 | 623 ms |
| 加 push / pull、运行时 POPCNT,两种测量顺序的中位数 | 371 / 405 ms |
| 同图、16 线程的 petgraph 对照 | 25,387 ms |
所有 128 个统计桶和最大可达距离 14 都一致。图里仍有孤立节点,不能把这个数字理解成任意两个站点都能在 14 步内互通。快了之后还得能对得上结果,这个约束一直没放松。
我一开始还要求去 crates 里找更好的实现。它确实比较了 petgraph 的 Bfs,也检查了其他 crate 的任务模型;最后通用实现没在这个全源统计场景里胜出,就没有为了“用个优秀依赖”硬塞进去。
这点我挺满意。要求用好东西,最后应该由实际任务和测量决定,包名本身不算加速器。
force-rs:少分配、少跨边界,342 次迭代照跑
力导布局这一边保留了原有力模型、节点顺序、theta=0.8、alphaDecay=0.02,以及完整的 342 次冷却迭代。
主要改动集中在连续内存的八叉树 arena、可复用缓冲、预计算遍历链接和弹簧系数。还有一个很实在的接口调整:增加 Simulation.run(),让一批迭代在 Rust 内完成。
之前逐 tick 跨 N-API 返回状态,每次涉及约 2.4 MB 数组。批量执行后,不必每做一点计算就把大数组交回 JS,再进入下一轮。这里独立测试最明确的收益是减少外部数组分配和 RSS,并没有证明 batching 本身缩短了 CPU 计算时间。
首轮独立 342 tick 测试,旧包是 42.989 秒,连续 arena 默认方案为 24.302 秒;显式 ordered 实验为 22.903 秒。这些是独立原生测试,不能直接拿来替换完整 build 的阶段耗时。
particular、barnes-hut-tree 等 crate 也检查过,但直接替换会改变现有力模型或近似语义,没有当成兼容升级接进来。Morton 排序保留成显式实验选项;一个通过差分检查的 packet 遍历实验,短基准反而更慢,最后删掉了。
“论文里最好的”“crates 里最强的”,落到工程里还是得加上后半句:在我这份输入、这套语义和这台机器上,实际有没有赢。
本地链接:别让 npm 发版成为调参循环的一部分
这次我专门要求,先本地构建、链接、反复测试,到合理程度再发版。
本地完成两个原生包编译后,用过的链接命令如下,分别在对应仓库执行:
# 在 force-rs 和 bfs-rs 仓库中分别执行bun link
# 在 FriendLinks 仓库中消费本地实现,不修改依赖清单bun link --no-save @xingwangzhe/force-rs @xingwangzhe/bfs-rs这样改 Rust、编译、跑真实图的反馈链就短了很多。要是每试一个数据结构都先发一次 npm,优化还没开始,时间先花在等包上了。
但本地链接通过还不能收工。最终两个包都发布了 0.3.0,跑完六平台 CI 后,FriendLinks 解除了链接,安装实际 registry 包,再重跑完整验证。最终验收用的是正式包,而不是我电脑上某个刚编译好的文件。
| 完整构建场景 | 墙钟时间 | 测量含义 |
|---|---|---|
| 原流水线,正式 npm 0.2.3 | 110.97 s | 单次完整基线 |
正式 npm 0.3.0,--force |
54.01 s | 禁用 Astro 与新增应用缓存,完整重算 |
| 正式 npm 0.3.0,首次写入最终缓存 | 42.25 s | 完整计算并生成可复用缓存 |
| 正式包缓存命中,第 1 次 | 6.93 s | 校验源文件内容,复用图、统计和压缩产物 |
| 正式包缓存命中,第 2 次 | 7.07 s | 相同输入再次验证 |
强制重算相对原基线减少 51.3%,峰值 RSS 从约 2.46 GiB 降到 1.40 GiB。两次缓存命中平均 7.00 秒。
开发阶段本地候选有一轮跑到 47.09 秒,记录也保留了。不过最终正式包的强制验收是 54.01 秒,不能挑本地最快的一次充当发布结果;同样,7 秒是缓存复用,不能写成“全量重算只要 7 秒”。
缓存按内容校验,YAML、拓扑、布局、统计和压缩分别复用。只改站点描述时可以更新元数据、复用布局;真正影响布局的数据变化了,就得老老实实重算。native 二进制、运行环境等也进入相关缓存指纹,坏缓存会回退。
还试过给 YAML 解析加 Worker。两个 smol Worker 的一次探索性测试,从串行 6.114 秒变成 5.401 秒,只快了 11.7%,内存却从 273.7 MiB 涨到 408.3 MiB;四个反而要 6.789 秒。考虑到收益和额外复杂度,生产方案没上 Worker 池。
有时候折腾一圈,最后最合适的还是串行加复用。机器已经够忙了,没必要为了看起来并行而并行。
完整构建的测量方式也保留在仓库里:
/usr/bin/time -v bun run build --force
# 数据完全相同时,可额外传入旧 dist 目录进行精确对照bun scripts/verify-build-output.ts dist这里的冷构建是禁用应用缓存,并没有清空操作系统文件页缓存。完整记录见固定提交下的构建性能报告。
浏览器:我只是画节点,真需要 176 万个三角形吗
构建快了,浏览器的活还在。
前端已经使用 instancing,但 instancing 解决了批量提交,也不代表每个实例内部的几何量就免费了。近五万个球体加起来,节点本身仍有 1,766,304 个三角形。
最终改用 Three 官方的 SpriteNodeMaterial 和 TSL 实例属性:每个节点用两个三角形组成的 billboard,片元里处理圆形轮廓和球形明暗,视觉上保留球形节点的感觉。
这样节点几何量直接降到 98,128 个三角形,减少 94.44%。中心和半径使用 Float32,颜色使用 normalized RGBA8;原有 CPU 矩阵接口保留下来,让聚焦、缩放和拾取继续工作。
| 资源指标 | 优化前 | 优化后 |
|---|---|---|
| 节点 GPU 实例属性数组 | 3,728,864 B | 981,280 B |
| Three 记账的全景资源 | 34,008,639 B | 14,904,336 B |
| Three 记账的聚焦资源 | 35,795,359 B | 16,651,016 B |
| 全量背景线属性及索引 | 151,859,664 B | 77,650,264 B |
| 背景线隐藏后数组 | 保留已分配缓冲 | 0 B |
全景实际 draw calls 仍然是 2,里面还包含输出 pass。这里最明显的收益来自每次绘制要处理的内容变少了。
背景线保留原来的 16–32 段曲线和 Float32 坐标,用 indexed geometry 共享相邻端点,颜色压成 RGBA8。默认不分配全图背景缓冲,开启时才创建,隐藏后释放;悬停和聚焦则只处理当前相关的边。Three 的 BufferGeometry 文档里可以查到索引复用和资源释放接口。
高亮连线也按实际需要创建两个无光照实例批次,核心和光晕各一批,不再预建一大堆独立 Mesh;相接圆柱的内部端盖也去掉,减少无用几何和覆盖。
输出侧关闭 MSAA,使用不透明画布和 8bit 内部输出缓冲,默认 DPR 上限为 1。我的目标是让关系图清楚、能操作,没必要让它承担一套用不上的高精度输出成本。MDN 的 WebGL 性能建议也讨论了缓冲、分辨率和资源管理这些实际开销。
代价当然有。球形替身的深度位于 billboard 平面,贴得很近、穿进节点或靠近裁剪面时,表现与真正的球体不同;8bit 输出和颜色量化也会影响部分暗色渐变。CPU 矩阵还留着,Three 的资源记账也不等于设备总显存,更不能把属性数组下降说成 JS 堆一起下降。
这些取舍我能接受,数字和边界都摊开就行。
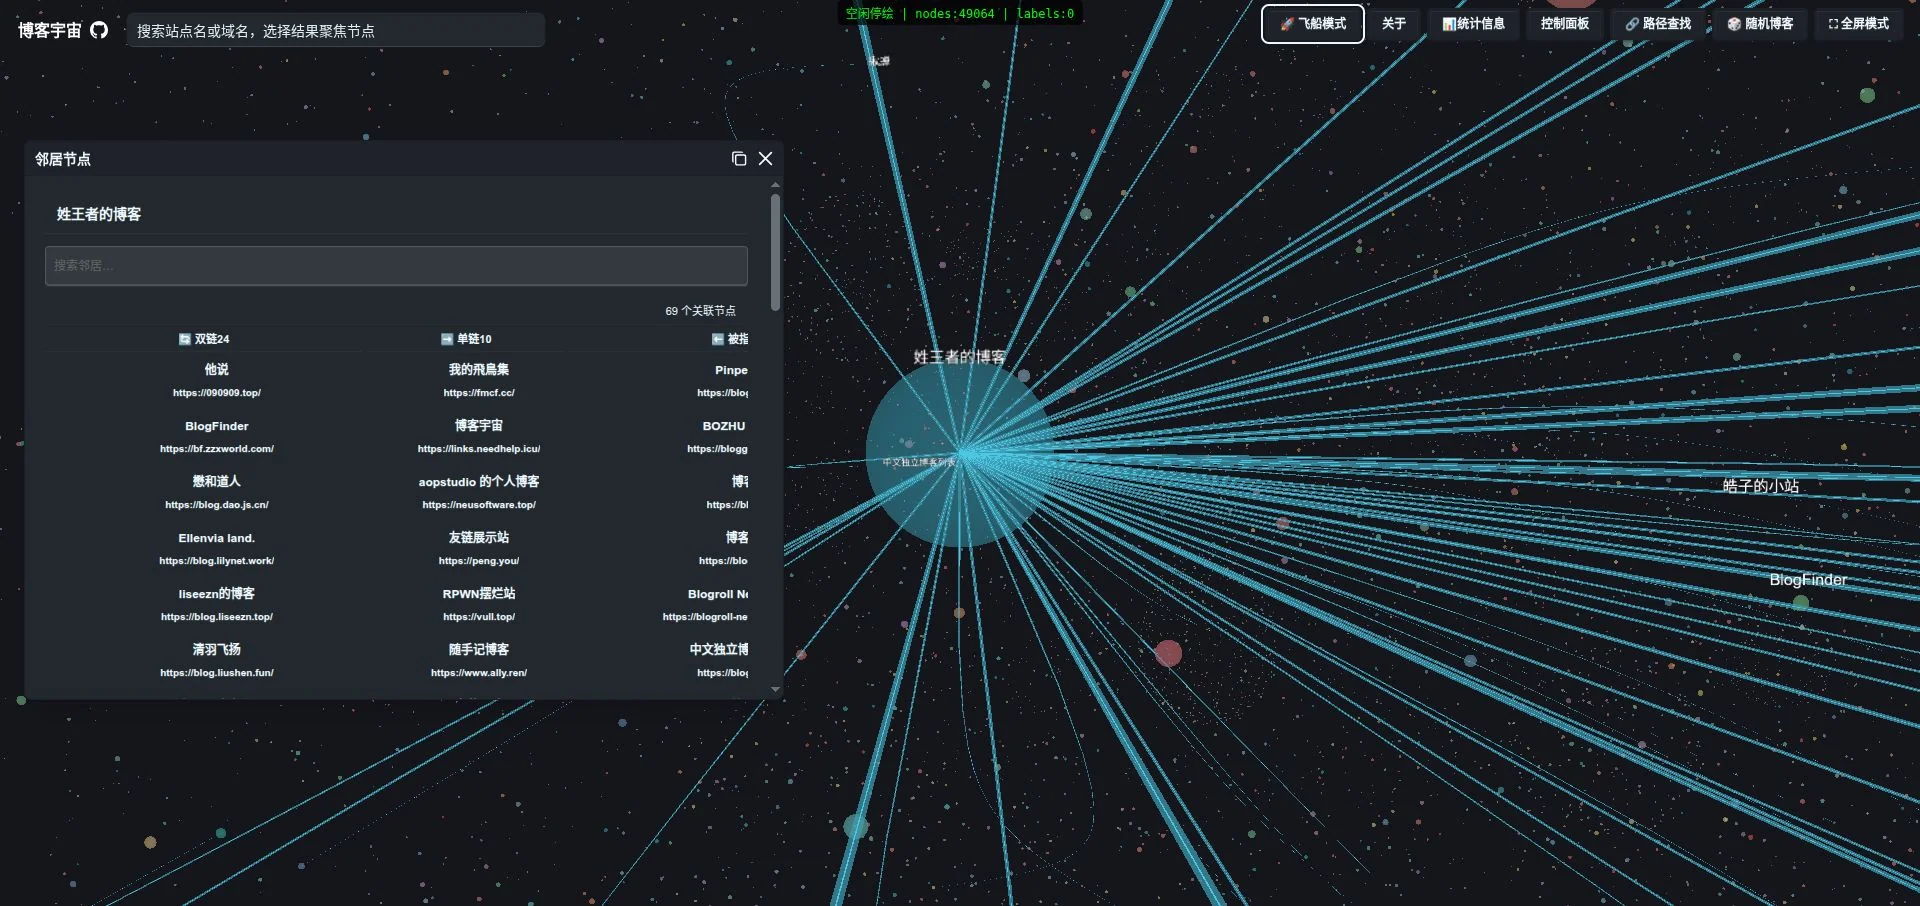
最终构建中的全量关系图,聚焦我的博客并展开邻居面板。截图来自实际浏览器。
比提高 FPS 更省的是:没变化,就别再画了
Three 官方有一篇 Rendering on Demand,讲的就是场景发生变化时才绘制。关系图很适合这种方式:我不拖动、不飞行、不搜索时,宇宙并没有什么必须一直动的东西。
需要说明,前端对照基线在上一阶段就已经支持按需停绘、BVH 和 lazy search。这轮继续压低活动绘制成本,并把等待标签批次等零碎工作也处理掉,不能把所有已有能力都算作这次新发明。
最终调度大致是这样:相机、控件或内容变化时请求一帧;阻尼、飞行还在进行就继续;稳定后不再申请下一帧;页面隐藏则暂停。标签每批最多创建四张纹理,下一批由可取消任务唤醒,等待期间不反复画同一张图。
标签候选也改用空间格查询附近节点,有界堆只保留预算内的最近候选。拾取使用 BVH 近处优先剪枝,球形节点用解析相交;相同 hover 射线复用结果,相机、矩阵或裁剪范围变化后失效,点击则重新检测。
最终可见页面静止两秒,新增绘制帧和标签扫描都是 0,没有待执行 RAF 或标签任务,背景数组也是 0。
不过这里还有一个我特意改回来的地方:默认不锁帧。
最初节能、均衡、清晰分别设了 30 / 45 / 60 FPS 上限。低配机器舒服了,高配机器却也被上限拦住。我后来补的要求是:
默认 60fps,默认无锁无上限。
最后落实成独立的“帧率上限”:默认无限制,60 Hz 屏幕通常约 60 FPS,高刷新率屏幕可以超过 60;需要节能时再手动选跟随画质限帧。画质继续控制 DPR 和标签预算,两者独立保存,切换画质不会偷偷把帧率重新锁上。实际 RAF 频率仍由浏览器、显示器和设备能力决定,可参考 MDN 的 requestAnimationFrame 说明。
调度测试模拟了 144 / 240 Hz,确认无限制模式逐个 RAF 都能绘制。真实浏览器连续请求绘制的功能探针中,30 FPS 档在 61 次 RAF 里绘制 30 帧;无限制模式在 59 次 RAF 里绘制 58 帧,采样时尾帧仍可能在队列里。
这个探针验证的是应用限帧已经解除。鼠标停下来,依然自动停绘,不会因为选了“无限制”就原地空转。
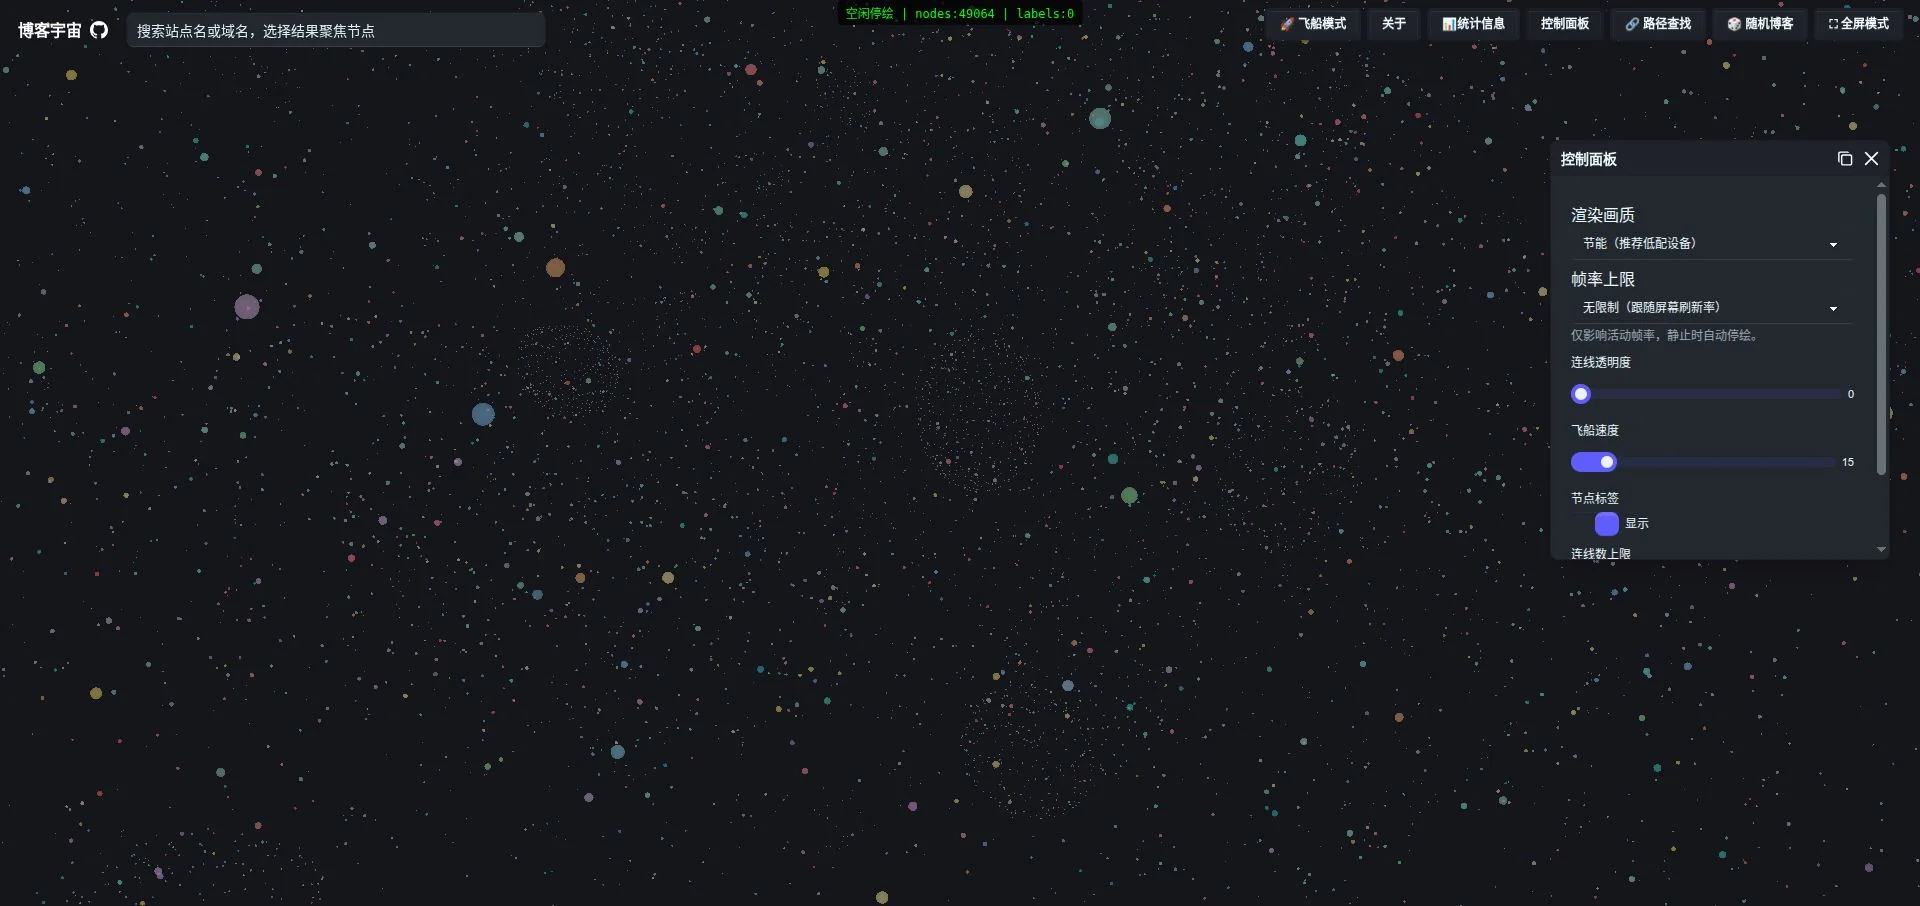
默认节能画质、DPR 上限 1,帧率选择无限制;顶部显示“空闲停绘”。
到底快了多少,交错测三轮再说
为了避免新数据改变布局,前后两版读取同一份冻结图,并核对相机、视口和 DPR。每个场景交错测试三轮、交换先后顺序,每轮预热 4 次、正式测量 20 次。
| 场景 | 第一轮旧 → 新 | 第二轮旧 → 新 | 第三轮旧 → 新 |
|---|---|---|---|
| 全景 | 7.30 → 3.40 ms | 7.15 → 3.50 ms | 8.55 → 4.05 ms |
| 聚焦我的博客、41 个邻居标签 | 6.55 → 4.20 ms | 9.90 → 4.20 ms | 11.00 → 5.50 ms |
计时从 renderer.render() 开始,到 WebGPU queue.onSubmittedWorkDone() 完成。这是包含 CPU 提交、驱动和 GPU 队列完成的串行延迟,探针还绕过了应用 FPS 上限。它能比较绘制工作,但不能直接拿倒数当成真实屏幕 FPS,也不是单独的 GPU timestamp。
全景每轮下降 51.0%–53.4%,聚焦每轮下降 35.9%–57.6%。初次探索还出现过聚焦 17–25 ms 的回退,原始记录没删,后面才通过同图、同镜头和交错顺序复核。
我觉得这比“某次跑出了一个特别好看的数”踏实。集显频率、系统负载都会影响绝对耗时,所以几何量、字节数和全部原始样本也一起留着。
那些不在大数字里的收尾
最容易被忽略的,往往是这些小地方:
| 位置 | 这轮处理 |
|---|---|
| 搜索 | 第一次非空查询才建索引,并发共享 Promise;输入加 150 ms 防抖、取消和过期结果保护 |
| 主线程 | 索引插入每 128 条让出一次执行机会,避免一口气霸占页面 |
| 统计窗口 | 首次成功后复用数据和 DOM,重开不反复请求 |
| 最短路径 | 队列使用 head 下标,回溯后反转,移除反复 shift / unshift 的搬移 |
| 生命周期 | 异步初始化后检查取消状态,迟到实例释放自己;销毁时清理 RAF、标签、请求和几何资源 |
| 飞行交互 | 未锁定鼠标时,首击交给重新锁定 handler,避免误打开准星中心或邻居标签对应的网站 |
| 依赖 | TypeScript 保持 6.0.3,补齐传递依赖安全更新,Bun 审计清零 |
首搜建库还没有变成免费的午餐。同图一次观测从 4.059 秒到 3.770 秒,仍然要等数秒;延迟建库只是让没搜索的人不必先付这笔成本。这块还值得继续折腾。
最终 FriendLinks 是 88 项测试、4875 次断言通过,astro check 检查 82 个文件,0 errors、0 warnings、7 hints。YAML、逻辑站点、图端点、统计、坐标、曲线精度和资源引用也做了产物校验。
正常 WebGPU 和强制 WebGL 的独立 renderer 都验过全量场景,WebGL 没有 shader 错误,getError()=0。窗口拖动、缩放、窄屏边界、搜索、路径步进和飞行也有浏览器记录。自动化注入 Escape 没触发原生解锁,就按实际记录使用显式解锁,没有把它写成“实体 Esc 已验证”。
最终提交是 cb538705,对应 GitHub CI已经通过。原生包的发布与 FriendLinks 的正式包消费也都走完了。
GPT-6.1 sol Ultra 的“神力”在哪
这次让我觉得离谱的,是整条链都能接着往下做。
从 Three.js 的一帧开销,查到 Rust 包里的数据结构;从论文思路、crate 对照,接到本地链接和真实图;再从包发布回到消费项目,继续核对产物、浏览器交互和 CI。中间测输了的方案要撤,出现的边界问题要修,最后还得把正式包真正用上。
我不用为了这一次优化,先把这些项目所有实现细节都学一遍再开始。但我仍然能提出约束:图别少算,力模型别偷换,老机器别空转,好机器别被锁帧,最后把数据给我。
标题叫“极致优化”,是这次我给它定的方向;从结果里能确认的,是这些方案在这份图和测试条件下确实赢了。至于所有图、所有硬件上的全局最优,这次实验可没证明。
前面那篇文章里,我感叹 AI 帮我造出了两个 Rust 轮子。这回轮子已经在跑,它又钻进去把重复分配、边界搬运、重复遍历和没必要的绘制一点点抠掉。
一个博客关系图,最后折腾成了跨仓库的算法与渲染实验。我的需求还是那句:渣机少喘两口气,高配该跑多快跑多快。
这次 GPT-6.1 sol Ultra,确实让我有点服。
3D 关系图的极致优化:GPT-6.1 sol Ultra 的神力
作者:xingwangzhe
本文链接:https://xingwangzhe.fun/posts/3d-graph-extreme-optimization-gpt-6-1-sol-ultra/
本文采用知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议进行许可。
留言评论
评论资源加载失败,请重试。